Dalam dunia machine learning, tidak banyak algoritma yang menawarkan kombinasi kekuatan, kestabilan, dan kemudahan penggunaan sekaligus. Random Forest adalah salah satu pengecualian yang menonjol. Algoritma berbasis ensemble learning ini telah menjadi andalan para praktisi data, baik untuk tugas klasifikasi maupun regresi, karena kemampuannya menghasilkan prediksi yang akurat sekaligus tangguh terhadap berbagai masalah data. Artikel ini akan membahas secara mendalam tentang cara kerja Random Forest, keunggulan dan keterbatasannya, serta bagaimana menerapkannya dengan Python menggunakan pustaka scikit-learn.
Apa Itu Random Forest?
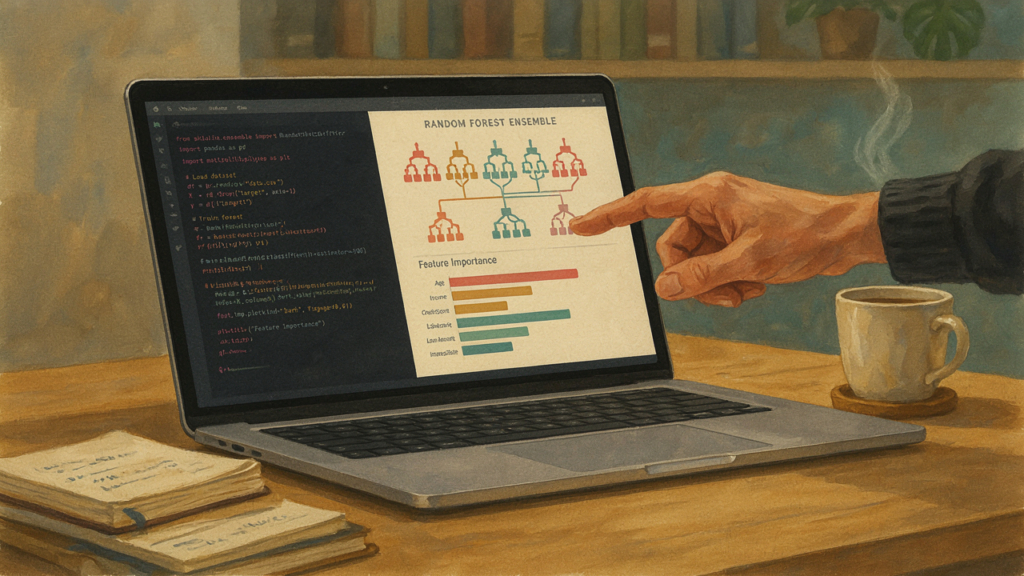
Random Forest adalah algoritma machine learning yang termasuk dalam keluarga metode ensemble, yaitu teknik yang menggabungkan banyak model sederhana untuk membentuk satu model yang lebih kuat. Seperti namanya, Random Forest terdiri dari sekumpulan pohon keputusan (decision tree) yang bekerja bersama-sama. Alih-alih mengandalkan satu pohon yang rentan terhadap overfitting, Random Forest membangun banyak pohon dan menggabungkan hasilnya untuk menghasilkan prediksi akhir.
Konsep dasarnya sederhana: jika satu pohon keputusan bisa membuat kesalahan karena terlalu menghafal pola data latih, maka kumpulan banyak pohon yang saling independen akan saling mengoreksi kesalahan tersebut. Dalam istilah statistik, ini dikenal sebagai pengurangan varians. Dengan merata-ratakan hasil dari banyak model, Random Forest mengurangi fluktuasi prediksi yang membuat model tunggal tidak stabil.
Cara Kerja Random Forest
Untuk memahami Random Forest secara mendalam, kita perlu mengenal dua teknik inti yang menjadi fondasinya: bagging (bootstrap aggregating) dan pemilihan fitur acak (random feature selection).
Bootstrap Aggregating (Bagging)
Bagging adalah teknik di mana setiap pohon dilatih menggunakan sampel acak dari data latih yang diambil dengan pengembalian (sampling with replacement). Artinya, dari dataset berukuran N, kita mengambil N sampel secara acak, tetapi satu titik data tertentu bisa muncul lebih dari sekali, sementara data lain mungkin tidak terpilih sama sekali. Proses ini dilakukan untuk setiap pohon dalam forest, sehingga setiap pohon melihat versi data yang sedikit berbeda.
Keberagaman antar pohon ini justru menjadi kekuatan utama Random Forest. Karena setiap pohon dilatih pada subset data yang berbeda, mereka akan membuat kesalahan yang berbeda pula. Ketika hasil mereka digabungkan, kesalahan-kesalahan ini cenderung saling meniadakan.
Pemilihan Fitur Acak
Selain mengacak data, Random Forest juga mengacak fitur. Pada setiap titik percabangan sebuah pohon, algoritma hanya mempertimbangkan sebagian kecil dari seluruh fitur yang tersedia untuk menentukan pemisahan terbaik. Jika dataset memiliki 100 fitur, misalnya, setiap percabangan mungkin hanya mempertimbangkan sekitar 10 fitur yang dipilih secara acak.
Teknik ini semakin memperkuat keberagaman antar pohon. Tanpa langkah ini, pohon-pohon yang kuat akan selalu memilih fitur dominan yang sama di percabangan atas, sehingga seluruh forest menjadi sangat mirip dan kehilangan keunggulan ensemble-nya.
Proses Prediksi
Untuk tugas klasifikasi, Random Forest menggunakan majority voting — kelas yang paling banyak dipilih oleh para pohon menjadi prediksi akhir. Sementara itu, untuk regresi, Random Forest merata-ratakan nilai prediksi dari semua pohon. Pendekatan agregasi inilah yang membuat hasil akhir jauh lebih stabil dibandingkan prediksi dari satu pohon tunggal.
Keunggulan Random Forest
Random Forest populer karena menawarkan berbagai keunggulan yang membuatnya cocok untuk banyak skenario nyata.
Akurasi tinggi dan kestabilan. Berkat kombinasi banyak pohon, Random Forest umumnya menghasilkan akurasi yang lebih tinggi dibandingkan pohon keputusan tunggal sekaligus lebih stabil — perubahan kecil pada data tidak akan mengubah hasil secara drastis.
Tahan terhadap overfitting. Meskipun tidak sepenuhnya kebal, Random Forest jauh lebih tahan terhadap overfitting berkat mekanisme bagging dan pemilihan fitur acak yang menjaga generalisasi model.
Mampu menangani data non-linear dan interaksi fitur. Random Forest dapat menangkap hubungan kompleks antar fitur tanpa perlu transformasi data manual atau asumsi distribusi tertentu.
Menangani missing value dan data campuran. Algoritma ini bekerja baik dengan data kategorikal maupun numerik, dan cukup toleran terhadap nilai yang hilang.
Memberikan peringkat kepentingan fitur. Salah satu fitur paling berguna adalah kemampuannya mengukur seberapa penting setiap fitur terhadap prediksi, yang sangat membantu dalam analisis dan seleksi fitur.
Skalabilitas yang baik. Karena setiap pohon dapat dilatih secara independen, Random Forest cocok untuk diparalelkan dan dapat menangani dataset berukuran besar dengan efisien.
Keterbatasan Random Forest
Meskipun kuat, Random Forest bukan tanpa kekurangan, dan memahami keterbatasannya sama pentingnya dengan mengenal keunggulannya.
Interpretabilitas rendah. Tidak seperti pohon keputusan tunggal yang mudah divisualisasikan dan dijelaskan, Random Forest berperilaku seperti “kotak hitam”. Sulit untuk menjelaskan mengapa model menghasilkan prediksi tertentu secara intuitif.
Biaya komputasi besar. Melatih ratusan atau ribuan pohon membutuhkan waktu dan sumber daya komputasi yang signifikan, terutama untuk dataset dengan banyak fitur dan sampel.
Kurang efektif untuk data berdimensi sangat tinggi. Meskipun bagus untuk banyak fitur, Random Forest bisa kesulitan ketika jumlah fitur sangat besar dengan banyak fitur yang tidak relevan, karena fitur acak yang tidak berguna dapat mendominasi pemilihan.
Kurang ideal untuk data temporal atau deret waktu. Karena sifat acaknya, Random Forest tidak secara alami menangkap ketergantungan sekuensial dalam data deret waktu, meskipun dapat diadaptasi dengan rekayasa fitur.
Implementasi Random Forest dengan Python
Python, melalui pustaka scikit-learn, menyediakan implementasi Random Forest yang lengkap dan mudah digunakan. Berikut adalah panduan langkah demi langkah untuk membangun model klasifikasi.
Persiapan Data
Kita akan menggunakan dataset Iris yang sudah tersedia di scikit-learn sebagai contoh sederhana namun ilustratif.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Memuat dataset
iris = load_iris()
X = iris.data
y = iris.target

# Membagi data latih dan uji
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)
Melatih Model
Membangun model Random Forest sangatlah mudah dengan kelas RandomForestClassifier.
from sklearn.ensemble import RandomForestClassifier

# Membuat model dengan 100 pohon
model = RandomForestClassifier(
    n_estimators=100,
    max_depth=None,
    random_state=42
)

# Melatih model
model.fit(X_train, y_train)
Evaluasi Model
Setelah model dilatih, kita mengevaluasi performanya pada data uji.
from sklearn.metrics import accuracy_score, classification_report

# Memprediksi data uji
y_pred = model.predict(X_test)

# Mengukur akurasi
akurasi = accuracy_score(y_test, y_pred)
print(f"Akurasi: {akurasi:.2f}")

# Laporan klasifikasi lengkap
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Dengan dataset Iris yang relatif sederhana, Random Forest biasanya mampu mencapai akurasi hampir sempurna, menunjukkan betapa efektifnya algoritma ini bahkan untuk tugas klasifikasi dasar.
Analisis Kepentingan Fitur (Feature Importance)
Salah satu keunggulan utama Random Forest adalah kemampuannya menunjukkan fitur mana yang paling berkontribusi terhadap prediksi.
import numpy as np

# Mengambil tingkat kepentingan fitur
importances = model.feature_importances_

# Menampilkan fitur beserta tingkat kepentingannya
for nama, nilai in zip(iris.feature_names, importances):
    print(f"{nama}: {nilai:.4f}")
Output ini membantu kita memahami struktur data dan dapat digunakan untuk menyederhanakan model dengan menghapus fitur yang kurang relevan.
Menyetel Hyperparameter (Hyperparameter Tuning)
Performa Random Forest sangat dipengaruhi oleh pemilihan hyperparameter. Beberapa hyperparameter penting yang perlu diperhatikan antara lain:
- n_estimators: jumlah pohon dalam forest. Semakin banyak pohon umumnya semakin stabil, tetapi menambah biaya komputasi.
- max_depth: kedalaman maksimum setiap pohon. Nilai yang lebih dalam meningkatkan risiko overfitting.
- min_samples_split: jumlah minimum sampel yang diperlukan untuk membagi sebuah node internal.
- min_samples_leaf: jumlah minimum sampel yang harus ada pada setiap leaf node.
- max_features: jumlah fitur yang dipertimbangkan pada setiap percabangan.
Untuk menemukan kombinasi hyperparameter terbaik, kita dapat menggunakan Grid Search atau Randomized Search dengan validasi silang.
from sklearn.model_selection import GridSearchCV

# Mendefinisikan grid hyperparameter
param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [None, 10, 20],
    'min_samples_split': [2, 5, 10]
}

# Melakukan grid search dengan validasi silang
grid = GridSearchCV(
    RandomForestClassifier(random_state=42),
    param_grid,
    cv=5
)
grid.fit(X_train, y_train)

# Menampilkan parameter terbaik
print(f"Parameter terbaik: {grid.best_params_}")
print(f"Akurasi terbaik: {grid.best_score_:.2f}")
Random Forest untuk Regresi
Random Forest tidak hanya unggul dalam klasifikasi tetapi juga sangat kompeten dalam tugas regresi. Dengan menggunakan RandomForestRegressor, kita dapat memprediksi nilai kontinu seperti harga rumah, permintaan produk, atau metrik bisnis lainnya.
from sklearn.ensemble import RandomForestRegressor
from sklearn.datasets import make_regression
from sklearn.metrics import mean_squared_error, r2_score

# Membuat dataset regresi sintetis
X, y = make_regression(n_samples=1000, n_features=10, noise=0.1, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Melatih model regresi
reg = RandomForestRegressor(n_estimators=100, random_state=42)
reg.fit(X_train, y_train)

# Evaluasi
y_pred = reg.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f"Mean Squared Error: {mse:.2f}")
print(f"R-squared: {r2:.4f}")
Kemampuan Random Forest menangkap hubungan non-linear tanpa perlu rekayasa fitur yang rumit membuatnya menjadi pilihan utama untuk banyak masalah regresi di dunia nyata.
Kapan Menggunakan Random Forest?
Random Forest adalah pilihan yang sangat baik ketika kita menghadapi data tabular dengan hubungan yang kompleks, ingin model yang kuat dengan sedikit penyesuaian manual, dan membutuhkan perkiraan kepentingan fitur. Algoritma ini cocok sebagai baseline yang solid — sering kali sulit dikalahkan oleh model yang lebih rumit tanpa penyetelan ekstensif.
Namun, jika interpretabilitas adalah prioritas utama, atau datanya berupa deret waktu dengan ketergantungan temporal yang kuat, model lain seperti regresi logistik, pohon keputusan tunggal, atau model berbasis RNN/LSTM mungkin lebih tepat.
Penutup
Random Forest adalah algoritma yang luar biasa karena berhasil menggabungkan kekuatan banyak model sederhana menjadi satu sistem yang kuat dan stabil. Kemampuannya menangani data kompleks, ketahanannya terhadap overfitting, serta kemudahan implementasinya dengan Python menjadikannya salah satu alat paling berharga dalam perangkat setiap praktisi machine learning.
Dengan memahami cara kerjanya, keunggulan dan keterbatasannya, serta menguasai penerapannya melalui scikit-learn, Anda telah membekali diri dengan keterampilan yang sangat dicari di industri. Mulailah bereksperimen dengan hyperparameter, eksplorasi fitur importance, dan bandingkan performanya dengan algoritma lain untuk menemukan potensi penuh dari Random Forest.
Related Posts
Reasense Tips: Langkah Efektif Menulis Karya Ilmiah Berkualitas
Menulis karya ilmiah berkualitas bukan sekadar menyusun kalimat demi kalimat…
Analisis Kualitatif & Visualisasi Lanjutan Menggunakan NVivo: Panduan Praktis untuk Peneliti
Penelitian kualitatif sering kali dihadapkan pada tantangan pengelolaan data yang…
50+ Topik Penelitian Pemasaran dan Tips Memilihnya untuk Mahasiswa
Memilih topik penelitian pemasaran yang tepat sering kali terasa membingungkan.…