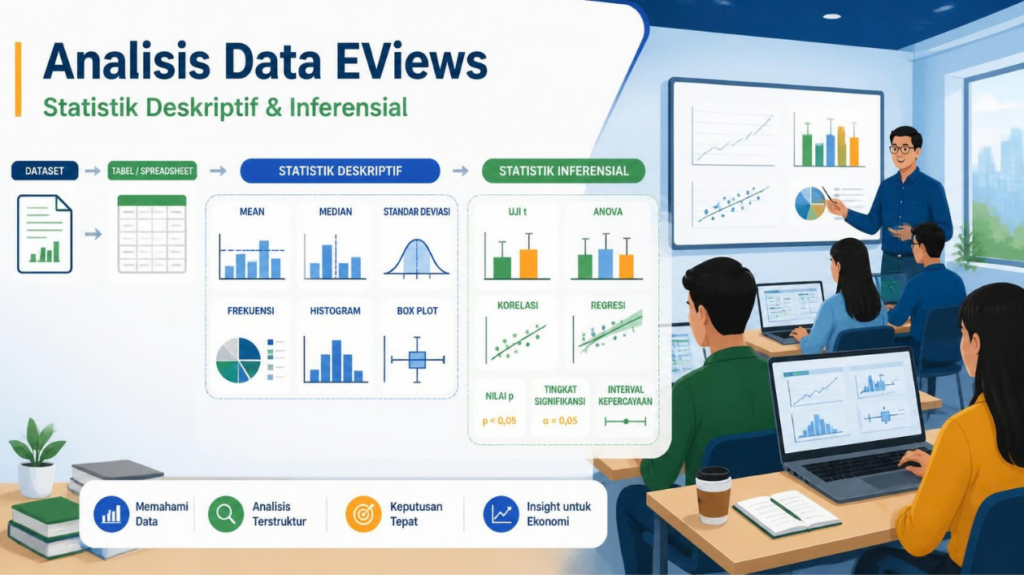
EViews (Econometric Views) telah menjadi salah satu perangkat lunak andalan bagi mahasiswa, peneliti, maupun praktisi ekonomi dan keuangan untuk mengolah data kuantitatif. Keunggulan utamanya terletak pada antarmuka yang intuitif serta kemampuannya menangani analisis statistik yang relatif kompleks, mulai dari tahap eksplorasi data hingga pengujian hipotesis. Dalam praktik analisis data, terdapat dua pendekatan besar yang saling melengkapi, yakni statistik deskriptif dan statistik inferensial. Menurut Reasense, memahami keduanya secara utuh menjadi fondasi penting sebelum melangkah ke pemodelan ekonomi yang lebih rumit seperti regresi linier berganda, analisis deret waktu, ataupun data panel.
Memahami Statistik Deskriptif
Statistik deskriptif berfungsi untuk menggambarkan karakteristik dasar dari sekumpulan data tanpa bermaksud menarik kesimpulan yang melampaui data itu sendiri. Tujuannya adalah memberikan ringkasan yang jelas, ringkas, dan mudah dipahami mengenai pola, kecenderungan, serta penyebaran data. Dengan kata lain, statistik deskriptif menjawab pertanyaan seperti “bagaimana gambaran umum data saya?” atau “apakah distribusi data cenderung simetris atau miring?”
Ukuran Pemusatan Data
Ukuran pemusatan (measures of central tendency) menunjukkan nilai yang menjadi titik pusat atau nilai tipikal dari suatu kumpulan data. Beberapa ukuran yang paling sering digunakan meliputi:
- Mean (rata-rata) — nilai rerata seluruh observasi, dihitung dengan menjumlahkan semua nilai kemudian membaginya dengan jumlah data. Mean sangat sensitif terhadap keberadaan nilai ekstrem (outlier).
- Median (nilai tengah) — nilai yang berada tepat di tengah setelah data diurutkan. Median lebih tahan terhadap outlier sehingga sering dijadikan alternatif ketika distribusi data tidak simetris.
- Mode (modus) — nilai yang paling sering muncul dalam kumpulan data. Mode relevan baik untuk data kuantitatif maupun kategorikal.
Ukuran Penyebaran Data
Sementara pemusatan memberi tahu di mana data “berkumpul”, ukuran penyebaran (measures of dispersion) menjelaskan seberapa jauh data tersebar dari titik pusatnya. Ukuran yang umum dijumpai antara lain:
- Range (rentang) — selisih antara nilai maksimum dan minimum.
- Variance (ragam) — rata-rata kuadrat deviasi setiap nilai terhadap mean, menunjukkan seberapa luas variasi data.
- Standard deviation (standar deviasi) — akar kuadrat dari variance, dan karena satuannya sama dengan data asli, ia lebih mudah diinterpretasikan.
- Skewness (kemiringan) — ukuran asimetri distribusi. Nilai mendekati nol menandakan distribusi hampir simetris, nilai positif menandakan ekor memanjang ke kanan, dan nilai negatif menandakan ekor memanjang ke kiri.
- Kurtosis (keruncingan) — ukuran puncak distribusi. Kurtosis tinggi menunjukkan ekor yang lebih tebal dan puncak lebih runcing dibanding distribusi normal.
Memahami Statistik Inferensial
Berbeda dengan statistik deskriptif yang hanya meringkas data, statistik inferensial digunakan untuk menarik kesimpulan, membuat generalisasi, atau menguji hipotesis tentang populasi berdasarkan informasi dari sampel. Pendekatan ini memungkinkan peneliti menjawab pertanyaan seperti “apakah terdapat perbedaan yang signifikan?” atau “apakah hubungan antara dua variabel benar-benar ada dan tidak terjadi secara kebetulan?”
Pengujian Hipotesis
Inti dari statistik inferensial adalah pengujian hipotesis, yaitu prosedur sistematis untuk menguji dugaan (hipotesis) terhadap data empiris. Secara umum, prosesnya melibatkan perumusan hipotesis nol (H0) dan hipotesis alternatif (H1), pemilihan tingkat signifikansi (umumnya alpha sebesar 0,05 atau 0,01), perhitungan statistik uji, hingga pengambilan keputusan berdasarkan nilai probabilitas (p-value). Jika p-value lebih kecil dari alpha, maka H0 ditolak; sebaliknya, jika lebih besar, maka H0 gagal ditolak.
Jenis Pengujian yang Umum Digunakan
Terdapat beberapa jenis pengujian inferensial yang sering diterapkan, di antaranya:
- Uji t (t-test) — digunakan untuk membandingkan rata-rata, baik satu sampel terhadap nilai tertentu, dua sampel independen, maupun dua sampel berpasangan.
- Uji F (F-test) — umumnya dipakai untuk menguji signifikansi model secara simultan dalam regresi, atau membandingkan varians antar kelompok.
- Analisis Varians (ANOVA) — pengembangan dari uji t untuk membandingkan rata-rata lebih dari dua kelompok sekaligus.
- Uji Chi-Square — digunakan untuk menguji hubungan antara dua variabel kategorikal atau kesesuaian distribusi.
- Interval Kepercayaan (confidence interval) — rentang nilai yang dengan tingkat keyakinan tertentu memuat parameter populasi sebenarnya.
Praktik Analisis di EViews
Salah satu daya tarik EViews adalah kemudahannya dalam menjalankan kedua jenis analisis statistik tersebut hanya dengan beberapa langkah klik atau perintah sederhana.
Menghasilkan Statistik Deskriptif
Untuk memperoleh ringkasan statistik deskriptif, pengguna cukup memilih objek data (series atau group) yang dianalisis. Dengan membuka tabel data lalu memilih menu statistik ringkasan, EViews akan menampilkan tabel berisi nilai mean, median, maksimum, minimum, standar deviasi, skewness, kurtosis, hingga statistik Jarque-Bera beserta probabilitasnya. Statistik Jarque-Bera berguna untuk menguji normalitas distribusi data, sebuah asumsi yang kerap dibutuhkan dalam analisis parametrik.
Selain ringkasan berupa angka, EViews juga menyediakan visualisasi seperti histogram, boxplot, dan QQ-plot yang membantu peneliti memahami bentuk distribusi data secara intuitif sebelum melanjutkan ke tahap inferensi.
Melakukan Pengujian Inferensial
EViews mendukung berbagai pengujian inferensial secara langsung. Untuk uji t satu sampel atau dua sampel, pengguna dapat mengakses menu uji kesetaraan rata-rata (equality tests) yang tersedia pada objek series. Sementara itu, pengujian normalitas, autokorelasi, maupun heteroskedastisitas umumnya terintegrasi langsung pada output estimasi regresi.
Dalam konteks regresi linier, EViews menampilkan output lengkap yang mencakup koefisien estimasi, standar error, statistik t, p-value, serta nilai $R^2$ dan statistik F. Nilai-nilai inilah yang kemudian menjadi dasar bagi peneliti untuk menarik kesimpulan inferensial mengenai signifikansi hubungan antar variabel.
Urutan Kerja yang Disarankan
Agar analisis berjalan sistematis dan hasilnya dapat dipertanggungjawabkan, peneliti sebaiknya mengikuti alur kerja berikut:
- Persiapan data — impor data ke EViews, periksa kelengkapan, dan tangani data yang hilang (missing values) atau outlier bila diperlukan.
- Analisis deskriptif — tampilkan ringkasan statistik dan visualisasi untuk memahami karakteristik data.
- Uji asumsi — lakukan pengujian pendahuluan seperti uji normalitas sebelum memilih metode inferensial yang tepat.
- Analisis inferensial — laksanakan pengujian hipotesis sesuai tujuan penelitian.
- Interpretasi hasil — terjemahkan output statistik ke dalam kesimpulan yang bermakna secara ekonomi atau substantif.
Melalui urutan tersebut, statistik deskriptif dan inferensial tidak lagi dipandang sebagai dua teknik yang terpisah, melainkan sebagai satu kesatuan alur analisis yang saling menopang.
Penutup
Menguasai statistik deskriptif dan inferensial merupakan prasyarat penting bagi siapa pun yang hendak melakukan analisis data ekonomi secara serius. Statistik deskriptif memberikan peta awal mengenai kondisi data, sementara statistik inferensial memungkinkan peneliti menarik kesimpulan yang dapat digeneralisasikan melampaui sampel yang diteliti. Dengan dukungan EViews, kedua tahapan ini dapat dijalankan secara efisien dan akurat. Namun demikian, kecanggihan perangkat lunak tidak menggantikan pemahaman konseptual yang kuat. Penafsiran yang tepat atas setiap angka yang dihasilkan tetaplah menjadi tanggung jawab peneliti, sehingga hasil analisis tidak sekadar menjadi rangkaian angka, melainkan menjadi argumen ilmiah yang bermakna.
Related Posts
Analisis Komparasi dengan SPSS: Panduan Lengkap dari Konsep hingga Interpretasi
Analisis komparasi atau uji perbandingan merupakan salah satu teknik statistik…
Pengelolaan Data Kualitatif dengan NVivo: Coding, Query, dan Visualisasi Dasar
Penelitian kualitatif menghasilkan data yang kaya, mendalam, dan sering kali…
Membuat Analisis Data Eviews
Eviews (Econometric Views) telah menjadi salah satu perangkat lunak statistik…